大規模言語モデル(LLM)はどう動いているのか
事前学習から微調整、トランスフォーマーと自己注意機構まで。LLMの仕組みを理解することは、その限界とリスクを見積もるための前提になります。
生成AIが一般に広く知られるようになり、ChatGPT をはじめとする大規模言語モデル(LLM)は 多くの人にとって身近な存在になりました。一方で、「どう動いているのか」を説明できる人は そう多くありません。
仕組みを理解することには実利があります。モデルが何を得意とし、どこで壊れるのか。 バイアスがどこから入り込むのか。セキュリティ上のリスクをどう見積もるべきか。 これらはすべて、内部で起きていることの理解に依存しています。
学習のサイクル
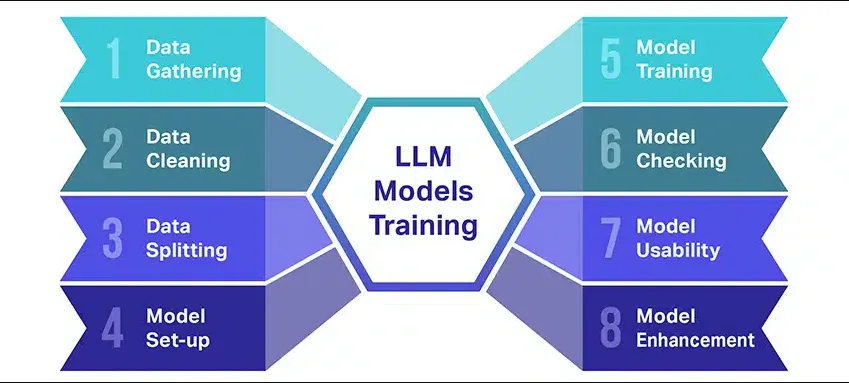
LLM は大きく3つの段階を経て作られます。
1. 事前学習(Pre-training)
最初に、大量のテキストデータを使った学習を行います。書籍、記事、Webサイトなど、 多様な情報源が含まれます。この段階でモデルが獲得するのは、言語の基本的なパターン、 文法、語彙といった土台です。特定のタスクを解いているわけではありません。
2. 微調整(Fine-tuning)
次に、翻訳・要約・質問応答といった特定のタスクに合わせてモデルを調整します。 汎用的に言語を扱えるモデルを、目的に沿って振る舞わせる段階です。
3. 評価
最後に性能を測り、実際のタスクでどれだけ役に立つかを検証します。 ここで見つかった弱点が次の改善につながり、最終的に複雑な言語タスクに 対応できる精度と信頼性が得られます。
基盤となる技術
LLM の挙動を支えているのは、Google が発表したトランスフォーマーアーキテクチャと、 その中核にある**自己注意機構(Self-Attention)**です。
トランスフォーマーはデータを並列に処理できるため、学習効率が大きく向上しました。 入力テキストはまず「トークン」という単位に分割され、各トークンがベクトルに変換されます。 自己注意機構は、そのベクトル同士の関係を計算することで、 文中のどの語がどの語に関係しているかを捉えます。
これが、文全体の意味を扱えることの技術的な理由です。
残っている課題
LLM は万能ではありません。実務で向き合うことになる制約がいくつもあります。
- 計算資源とエネルギー — 学習には膨大なリソースが必要で、環境負荷も無視できません
- バイアス — 学習データに含まれる偏りはモデルに反映されます。倫理面で最も議論されている論点です
- 未知の状況への弱さ — 学習の分布から外れた入力に対して、柔軟に対応できるとは限りません
- 過学習 — 学習データに適合しすぎると、新しいデータでの性能が落ちます
まとめ
生成AIの進化は速く、可能性は今も広がり続けています。 しかし同時に、バイアス、エネルギー消費、そしてセキュリティという課題への対応が 求められています。
仕組みと学習プロセスを理解しておくことは、この技術がどこへ向かうのかを 自分の頭で見極めるための、いちばん確実な足場です。
この記事は Medium にも掲載しています · Medium